
Rozwój modeli AI zwiększa ich zdolność do rozwiązywania złożonych problemów i lepszego rozumienia kontekstu, ale może jednocześnie wpływać na zmianę profilu ryzyka związanego z ich wykorzystaniem - wynika z kwietniowej analizy F5 Labs. Dane sugerują, że modele wyposażone w mechanizmy wieloetapowego wniosk...

Jak wynika z opublikowanego przez Fortinet dokumentu „2023 Cloud Security Report”, w chmurze publicznej znajduje się już ponad połowa danych prawie 40% ankietowanych przedsiębiorstw. W ciągu najbliższych 12-18 miesięcy odsetek tych firm zwiększy się do 58%, co spowoduje, że wyzwań związanych z zabezpieczani...
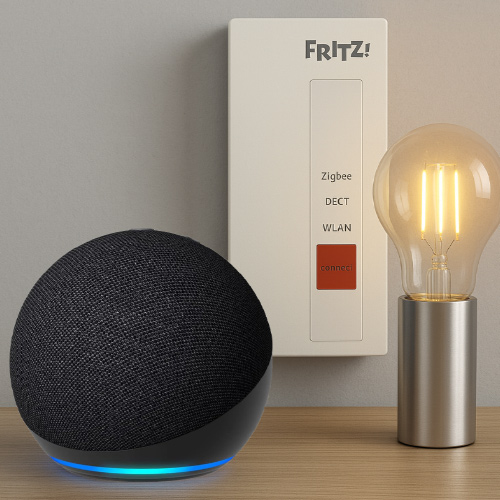
W dobie szybko rozwijających się technologii Smart Home coraz więcej użytkowników poszukuje rozwiązań, które pozwolą na wygodne i centralne zarządzanie inteligentnymi urządzeniami w domu. Połączenie bramki FRITZ!Smart Gateway z głośnikami Amazon Echo i asystentem Alexa to prosty sposób na wprowadze...

Zdaniem 45% respondentów przeprowadzonego przez IDC badania to nie ataki ransomware, lecz zachowanie kontroli nad infrastrukturą (w tym szyfrowaniem i utrzymaniem suwerenności danych) mogą w 2026 roku stać się największym wyzwaniem dla zapewnienia bezpieczeństwa i prywatności informacji. Potwierdzają to wyniki a...

Microsoft Azure to potężna platforma do budowania i uruchamiania aplikacji cloud-native. Jednak, jak potwierdzi każdy doświadczony architekt chmurowy lub inżynier SRE - monitorowanie środowiska Azure może przypominać próbę okiełznania chaosu. Setki metryk, logów i alertów napływających z maszyn wir...

Osoby, które w ostatnich tygodniach planowały rozbudowę komputera o dodatkową pamięć RAM lub szybszy dysk SSD, mogły przeżyć niemałe zaskoczenie. Ceny komponentów pamięci RAM i dysków wyraźnie poszły w górę, a wszystko wskazuje na to, że nie jest to chwilowa korekta, lecz efekt głębszych zmi...
 Generatywna sztuczna inteligencja (GenAI) coraz częściej trafia do firmowych komputerów. Pracownicy wykorzystują ją do pisania tekstów, analizy dokumentów czy programowania. Jest jednak druga strona tego trendu - każde zapytanie może oznaczać koszt, a niektóre nawyki użytkowników potrafią niepotrzebnie zwiększać liczbę zużywanych tokenów. Tym samym wzrost produktywności może generować nadmierne wydatki, których użytkownicy często nie dostrzegają.
Jak wskazuje Capgemini Polska, źródłem niepotrzebnych wydatków są przede wszystkim codzienne nawyki użytkowników: prowadzenie wielogodzinnych rozmów w jednym oknie czatu, przesyłanie całych dokumentów zamiast ich fragmentów czy proszenie modelu o generowanie znacznie większej ilości treści, niż jest faktycznie potrzebna.
W wielu usługach wykorzystujących duże modele językowe (LLM) jednym z elementów wpływających na koszt jest liczba przetwarzanych tokenów. Mówiąc najprościej, chodzi o porcje tekstu, które model musi „przeczytać” i wygenerować.
Dla użytkownika firmowego może to być całkowicie niewidoczne. Kliknięcie przycisku „Wyślij” nie wiąże się przecież z komunikatem w rodzaju: „Ta wiadomość właśnie kosztowała firmę 0,15 zł”.
Pojedyncza rozmowa nie musi robić dużej różnicy. Co jednak, jeśli z AI korzystają setki pracowników, a każdy z nich wykonuje dziennie dziesiątki podobnych operacji? Wtedy nawet pozornie niewielkie „marnotrawstwo” tokenów zaczyna przekładać się na wysokość opłat, drenując firmowe rachunki.
Jednym z problemów może być tzw. „puchnący kontekst”. Wyobraźmy sobie pracownika, który rano otwiera rozmowę z chatbotem i przez kilka godzin wykorzystuje to samo okno do kolejnych, niezwiązanych ze sobą zadań.
Na pierwszy rzut oka jest to wygodne. Model zna przecież wcześniejszy kontekst rozmowy. Z punktu widzenia kosztów sytuacja wygląda jednak inaczej.
Pozorna wygoda ma jednak swoją cenę. Przy kolejnych zapytaniach model musi uwzględniać coraz większą historię rozmowy. Jeśli do tego dochodzą przesłane wcześniej dokumenty, ilość przetwarzanych danych rośnie.
Capgemini zwraca uwagę, że problem nie ogranicza się wyłącznie do kosztów. Bardzo długie konwersacje mogą również negatywnie wpływać na jakość odpowiedzi, ponieważ model musi operować na coraz większej ilości informacji, z których część może być już nieistotna dla aktualnego zadania.
Dlatego prosta zasada może przynieść podwójną korzyść: nowe zadanie - nowa rozmowa.
Drugim problemem jest nadmierna długość generowanych odpowiedzi.
Przykładem niech będzie programista proszący AI o poprawienie jednej funkcji. Zamiast kilku zmienionych linii otrzymuje cały plik, szczegółowe wyjaśnienie, komentarze i dodatkowe rekomendacje. Przy okazji model wygenerował setki czy tysiące tokenów, których nikt nie potrzebował.
Podobnie może wyglądać praca z dokumentami. Użytkownik prosi o poprawienie jednego akapitu, a model generuje ponownie całą stronę albo cały dokument.
To nie tylko strata czasu. W usługach rozliczanych za tokeny oznacza również dodatkowe przetwarzanie.
Capgemini zwraca uwagę, że w wielu rozwiązaniach tokeny wyjściowe – czyli treści wygenerowane przez model – są droższe od tokenów wejściowych. Nadmiernie rozbudowana odpowiedź może więc bezpośrednio zwiększać koszt korzystania z AI.
Kolejny prosty sposób na ograniczenie zużycia tokenów to zmiana sposobu przekazywania danych.
Jeżeli użytkownik chce przeanalizować konkretną funkcję programu, nie zawsze potrzebuje przesyłać całe repozytorium. Jeśli interesuje go jeden fragment dokumentu, nie musi za każdym razem przekazywać kilkudziesięciu stron.
Zasada jest prosta: AI powinno otrzymywać przede wszystkim informacje potrzebne do wykonania konkretnego zadania.
Ma to również znaczenie z perspektywy bezpieczeństwa. Ograniczanie zakresu przesyłanych danych zmniejsza potencjalne ryzyko przypadkowego przekazania modelowi informacji, które nie są potrzebne do realizacji zadania.
Nie trzeba od razu wdrażać rozbudowanego systemu FinOps dla AI. Na początek wystarczy kilka prostych zasad.
1. Przesyłaj tylko potrzebny fragment
Nie wysyłaj całego dokumentu, jeśli AI ma poprawić jeden akapit.
2. Kończ rozmowę, gdy kończy się zadanie
Często lepiej rozpocząć nowy wątek niż dokładać kolejne polecenia do wielogodzinnej konwersacji.
3. Nie wymuszaj odpowiedzi, której nie potrzebujesz
Jeżeli wystarczy pięć zdań, nie proś modelu o kompleksowe opracowanie.
AI może realnie zwiększać produktywność, ale firmowy rachunek nie rośnie od samego faktu uruchomienia chatbota. Rosnąć może za to wtedy, gdy pracownicy bez potrzeby przesyłają ogromne ilości danych, prowadzą wielogodzinne rozmowy i generują treści, których nikt później nie wykorzystuje.
W przypadku pojedynczego pracownika może być to niezauważalne. Przy kilkuset użytkownikach korzystających z AI każdego dnia - już niekoniecznie. Dlatego obok zasad bezpieczeństwa i ochrony danych warto w firmach rozmawiać również o tym, jak korzystać z AI efektywnie - także pod względem kosztów.
Na umiejętne wykorzystywanie tokenów warto już zwrócić uwagę na początkowym etapie wdrażania pracowników do nowego modelu pracy, gdyż problem tokenów staje się jeszcze bardziej istotny wraz z przechodzeniem firm od pojedynczych chatbotów do agentów AI.
Źródło: Capgemini, opracowanie własne

